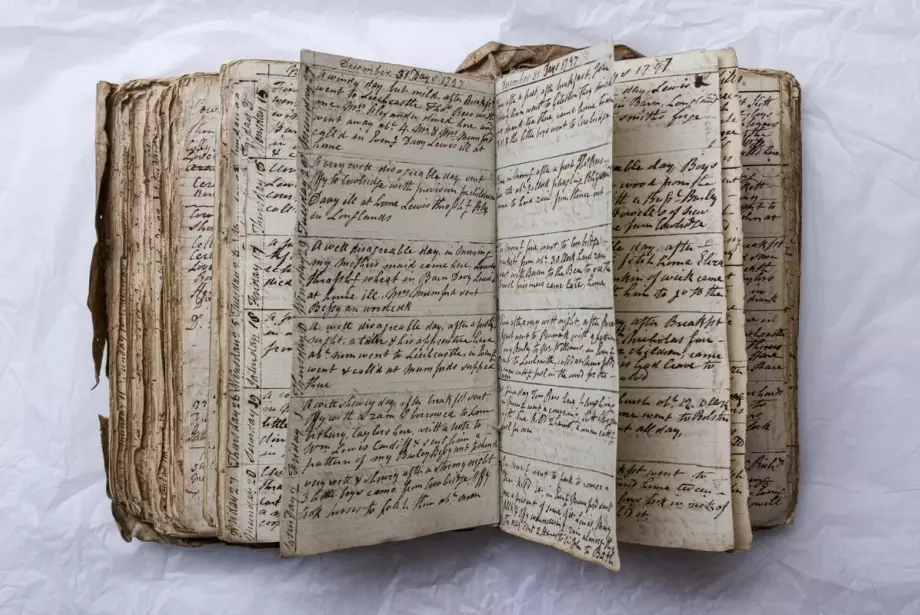
Há mais de um século, desde que o livreiro Wilfrid Voynich o adquiriu em 1912, um manuscrito resiste a todas as tentativas de leitura. Testes de radiocarbono apontam que o material foi produzido entre os anos de 1.404 e 1.438, período ao qual pertence um alfabeto sem equivalente em nenhum idioma já catalogado.
O acervo da Universidade de Yale, nos Estados Unidos, abriga as 240 páginas do documento na Biblioteca Beinecke de Livros Raros e Manuscritos. Entre os símbolos indecifráveis, aparecem desenhos de espécies vegetais sem correspondência na natureza, além de mapas do céu e representações de pessoas distribuídas pelo volume.
A dúvida permanece a mesma de décadas atrás: trata-se de um código complexo, de uma língua extinta sem registro em outro lugar, ou de uma invenção elaborada da época do Renascimento.
O que a inteligência artificial consegue medir
Como os métodos tradicionais não deram resultado, a aposta passou a ser em algoritmos capazes de mapear padrões invisíveis a olho nu. A tecnologia entra justamente onde a leitura humana trava: na contagem estatística de símbolos e no cálculo da entropia da escrita.
Professor de Engenharia de Software do Centro Universitário Uniceplac, Romes Heriberto compara essa ferramenta a uma lupa estatística usada para buscar regularidades no texto do códice, em entrevista ao Metrópoles. Segundo ele, o papel do computador é apontar onde existe organização, não traduzir palavra por palavra.
Padrões que imitam uma língua real
Nenhum trecho do Voynich parece resultado de letras jogadas ao acaso, de acordo com as análises computacionais já feitas. A forma como os termos se repetem segue a Lei de Zipf. Regra estatística que também aparece em idiomas falados por humanos, com poucas palavras muito frequentes e um grande número de termos raros.
Seções inteiras do manuscrito concentram vocabulário próprio conforme o assunto tratado, como botânica ou astronomia. Para o especialista em inteligência artificial Leo Soares, esse tipo de organização prova a existência de uma estrutura por trás do texto. Mas isso está longe de significar que o conteúdo foi finalmente traduzido.
A barreira que nenhum algoritmo resolve sozinho
Falta ao Voynich algo que outros enigmas históricos tiveram: um ponto de comparação direto entre duas línguas, como aconteceu com os hieróglifos egípcios graças à Pedra de Roseta. Esse tipo de referência cruzada costuma ser o que destrava a tradução de escritas desconhecidas.
Heriberto explica que decifrar qualquer texto normalmente exige algum apoio externo, recurso que o manuscrito simplesmente não oferece.
Soares reforça que a pouca informação disponível sobre idiomas antigos já extintos limita a confiabilidade dos testes computacionais. E os dois concordam que, sem uma chave vinda de fora, a inteligência artificial corre o risco de apontar uma solução que parece certa, mas não passa de coincidência estatística.
O que pode vir pela frente
Em 2025, uma descoberta do pesquisador Michael Greshko trouxe novo fôlego às investigações: o código Naibbe, técnica manual de cifragem do século 15 que combinava dados e cartas, consegue reproduzir em italiano e latim as mesmas propriedades estatísticas identificadas no texto do Voynich.
Romes Heriberto disse ao Metrópoles que o avanço depende de mais poder computacional e de novas evidências históricas que venham de arquivos, não apenas de algoritmos. Leo Soares reforça que a tecnologia amplia as oportunidades de análise, embora isso não signifique uma decifração garantida nem confirme se o manuscrito é uma mensagem cifrada, uma língua desconhecida, uma escrita artificial ou uma farsa.
Até que uma dessas duas frentes avance de verdade, o Voynich continua sendo o maior teste de limites da criptografia e da análise linguística moderna.